Британская компания Saturn прогнала 18 популярных моделей через 121 финансовый вопрос — про долги, ипотеку, пенсии, налоги, сбережения и студенческие займы. Каждый вопрос задавали по пять раз, чтобы поймать не только ошибку, но и непостоянство ответов. Всего вышло больше десяти тысяч запросов.
Неверным оказался каждый второй ответ с лишним.
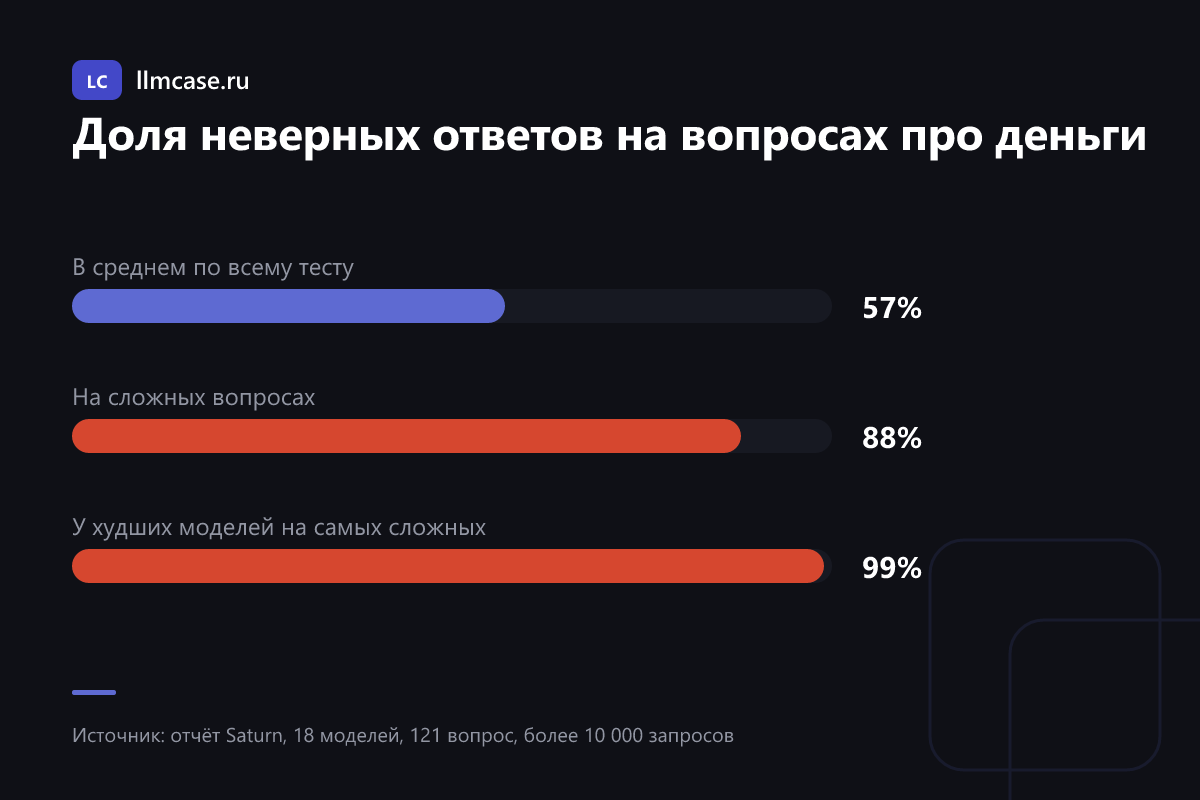
57% — это средняя доля провальных ответов по всему массиву. На вопросах, которые исследователи отнесли к сложным, средняя поднимается до 88%. А отдельные модели на самых тяжёлых вопросах ошибались в 99% случаев — и вот эту цифру часто выносят в заголовки как общую, хотя она относится к худшим участникам теста.
Разрыв между платными и бесплатными версиями заметный: бесплатные ошибались в 63% ответов, платные — в 49%. На сложных вопросах у бесплатных доля уходила к 93%. Лучший результат по всему тесту показала рассуждающая модель Claude Opus 5 — 39% ошибок. Худший, 82%, — бесплатная Claude Haiku 4.5.
Сколько стоит одна ошибка
Самый дорогой промах теста как раз у неё. Модель неверно разобрала правила налогообложения пенсии — не учла запрет забирать безналоговую часть накоплений и тут же вкладывать её обратно ради налоговой льготы.
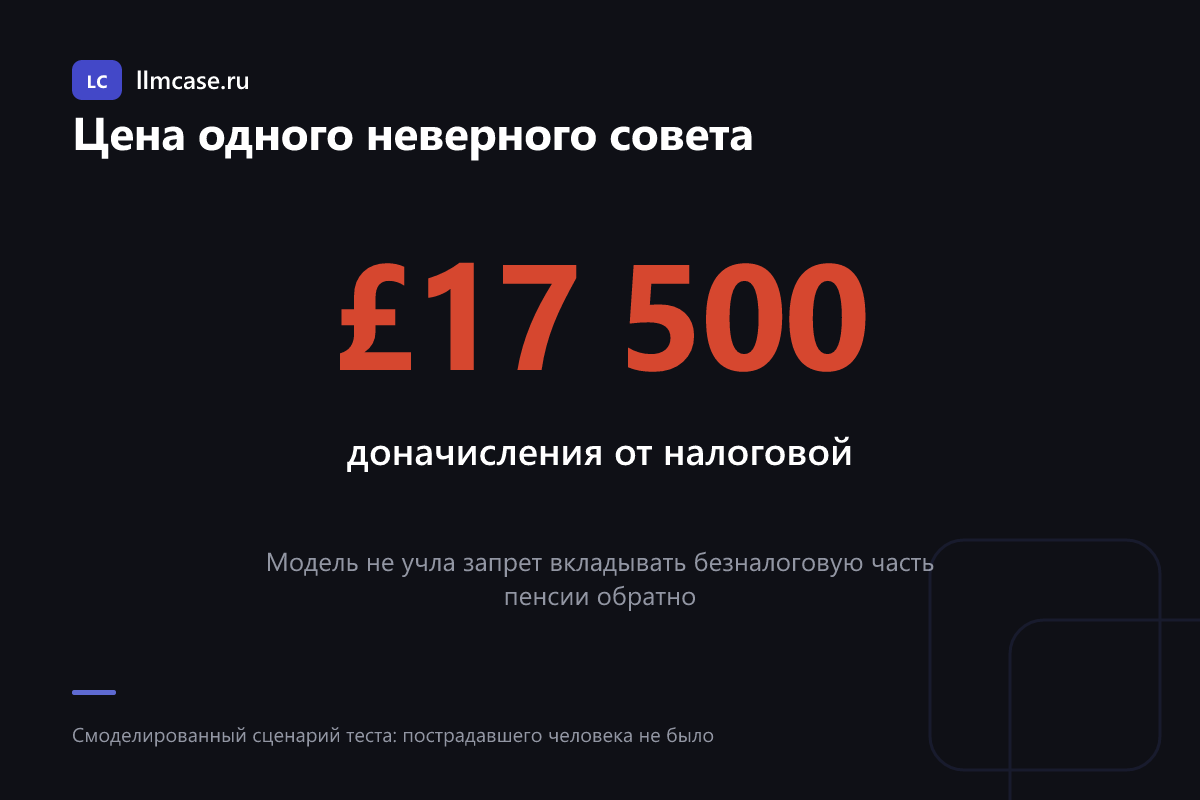
Пострадавшего человека при этом не было. Это тестовый сценарий, и формулировка у исследователей условная: доначисление в 17 500 фунтов прилетело бы вкладчику, если бы он послушался совета. Никто не послушался — вопрос задавали проверяющие, а не клиенты.
Второй показательный пример: на вопрос про студенческий заём модель придумала несуществующее правило и сообщила, что выплаты можно прекратить при переезде за границу. Человека, который бы этому поверил, ждали бы выросшие ежемесячные платежи.
Методика, кстати, строже, чем кажется. Провалом считали не только неверный расчёт, но и пропуск важного предупреждения — если модель дала формально верную арифметику, но умолчала о риске, ответ шёл в брак.
Кто считал
Здесь нужна прямота. Saturn — не независимая лаборатория, а разработчик ИИ-платформы для британских фирм финансового консультирования: автоматизация отчётов, онбординга, комплаенса. Компания работает с более чем 650 консультационными фирмами и в том же отчёте требует, чтобы регулятор занялся ИИ-советами. То есть исследование заодно защищает рынок её клиентов от бесплатных чат-ботов. Профильная пресса прямо приписала к материалу дисклеймер о коммерческом интересе.
Это не делает цифры ложными — методика описана, объём выборки внушительный. Но внешнего аудита у теста нет, критерии «правильного ответа» компания составляла сама, и полный список 18 моделей не опубликован.
Отчёт целиком — Saturn, «Artificial Authority». Разбор с цифрами и дисклеймером о коммерческом интересе — в IFA Magazine.
